Claudeの「Dreaming」って結局何なのか、正直よくわからないまま見出しだけ追っていませんか。
AIのアップデートが速すぎて、追いきれないのは自分だけじゃないはずです。
この記事では、Anthropic公式の発表内容をもとに、Dreamingの仕組みと中小企業の業務への関わり方を整理します。
3分で「自社に関係あるかどうか」が判断できる状態を目指しました。
2026年11月6日、Anthropicが「The components of agent memory」という技術解説を公開しました。SNSでは「ClaudeがDreaming(夢を見る)機能を搭載した」と話題になり、正直どこまで本当なのか半信半疑だった方も多いと思います。弊社でもAI導入を支援する立場として一次資料を読み込みましたが、ぶっちゃけ「夢を見る」という表現はやや誇張気味で、実態は地道なメモリ整理の仕組みでした。本記事では公式発表の中身を事実ベースで整理し、自社の問い合わせ対応やヘルプデスク業務にどう関わるかまで踏み込んで解説します。
Claudeの「Dreaming」とは?一言でいうと何をする機能?
Dreamingは、Claudeが過去のやり取りを振り返ってメモリを整理し直す、いわば「復習」の仕組みです。会話をしていない時間を使って、たまった記録の中から重要な情報だけを抜き出し、次回以降のセッションで使いやすい形に整えます。Anthropicの公式発表によると、この処理はオフライン時に行われるとされています。
SNSでは「次からもっと賢く動けるようにする機能」という説明が広がりましたが、これはかなり的確な比喩です。人間でいえば、一日の終わりに日記をつけて、翌日の自分のために大事な点だけメモし直すイメージに近いといえます。
公式資料では、Dreamingが行う処理として次のような内容が挙げられています。
▼Dreamingが行う主な処理
メモリの誤り修正
過去に記録した内容に間違いがあれば、気づいた時点で訂正します
ノートの作成
重要な出来事や学びをメモリノートという形で書き残します
メモリ表現の構築
ばらばらの記録を、後から使いやすい形にまとめ直します
事前読み込みの準備
次回セッションの冒頭で読み込む内容をあらかじめ形作ります
要するに、応答のたびに過去のやり取りを全部読み返すのではなく、必要な部分だけをあらかじめ整理しておくことで、少ない処理量で記憶を活かせるようにする工夫です。次の章では、この発表がいつ出たものなのか、過去のアップデートの流れとあわせて整理します。
いつ発表された?Claudeのメモリ機能アップデートの流れ
Dreamingは、2026年11月6日にAnthropicが公式ブログで発表した技術解説の中で紹介された機能です。Engineeringチームによる投稿で、「Agents」「Context engineering」「Agent memory」というトピックのもとに公開されています。GIGAZINEの解説記事は、その翌日にあたる2026年11月9日17時53分に公開されました。
Claudeのメモリ機能は、今回が初めての話題ではありません。これまでの大きな動きを時系列で整理すると、次のようになります。
| 時期 | 出来事 | 出典 |
|---|---|---|
| 時期不明 | メモリ機能が全ユーザー向けに開放されたとされる(時期・出典は未確認) | 本記事の一次資料には記載なし |
| 時期不明 | 記憶の仕組みに変更があったとされる(時期・出典は未確認) | 本記事の一次資料には記載なし |
| 2026年11月6日 | Anthropicが「The components of agent memory」を公式発表、Dreamingを含むメモリの仕組みを技術的に解説 | Anthropic公式 |
2026年3月・7月の動きについては、本記事が土台とする一次資料に直接の記載がないため、他メディアの報道として参考情報にとどめます。確実に言えるのは、11月6日の発表が「メモリをどう整理するか」という一歩踏み込んだ技術解説だったという点です。
この発表を正しく理解するには、まず「メモリ機能」そのものが何を指すのかを押さえておく必要があります。次の章で、Dreamingとメモリ機能の関係を整理します。
agent memory(エージェントメモリ)とは?Dreamingとの違いは?
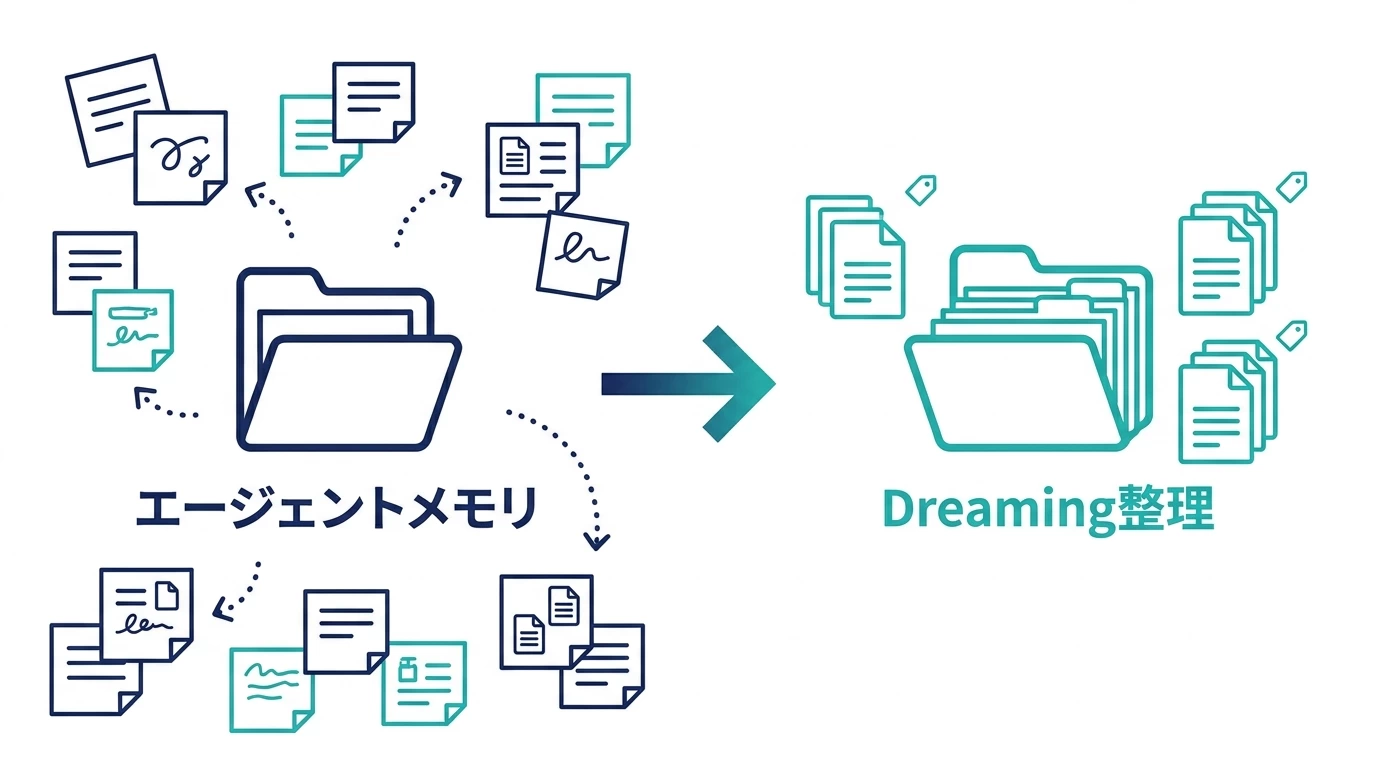
agent memory(エージェントメモリ)とは、Claudeがユーザーとのやり取りやタスクから得た知識のうち、セッションをまたいで保持され、後から読めるコンテキストとして保存されるものを指します。Dreamingは、このagent memoryを整理するプロセスの一つという位置づけです。両者は「保存される中身」と「それを整理する処理」という別の役割を持っています。
Anthropicの公式発表では、agent memoryは他の似た概念ともはっきり区別されています。混同しやすいので、ここで整理しておきましょう。
| 概念 | 内容 | agent memoryとの違い |
|---|---|---|
| agent memory | セッションをまたいで保持され、後で読めるコンテキストとして保存される知識 | 本記事の主題そのもの |
| モデルの重み変更 | モデル自体の学習・再訓練によって能力が変わること | セッションの記録ではなく、モデルの土台そのものの変化 |
| インコンテキスト学習 | 同じ会話の中で与えられた情報をもとに応答を調整すること | 会話が終わると引き継がれない点が異なる |
| compaction | 古いやり取りを要約に置き換えて、やり取りの分量を圧縮する処理 | 情報を要約で圧縮する処理であり、メモリとして別に保存し直すわけではない |
Claudeは、セッションログの中の重要な出来事にタグ付けしたり、メモリノートのフォルダのようなメモリストアに書き込んだりできるとされています。Dreamingは、このメモリストアの中身を整理し、将来のセッションで取り出しやすい形に作り変える役割を担います。
言葉だけだとイメージしづらいので、次の章では公式資料が示す具体的な機能の中身を見ていきます。
Dreamingは具体的に何ができる?公式が示す機能
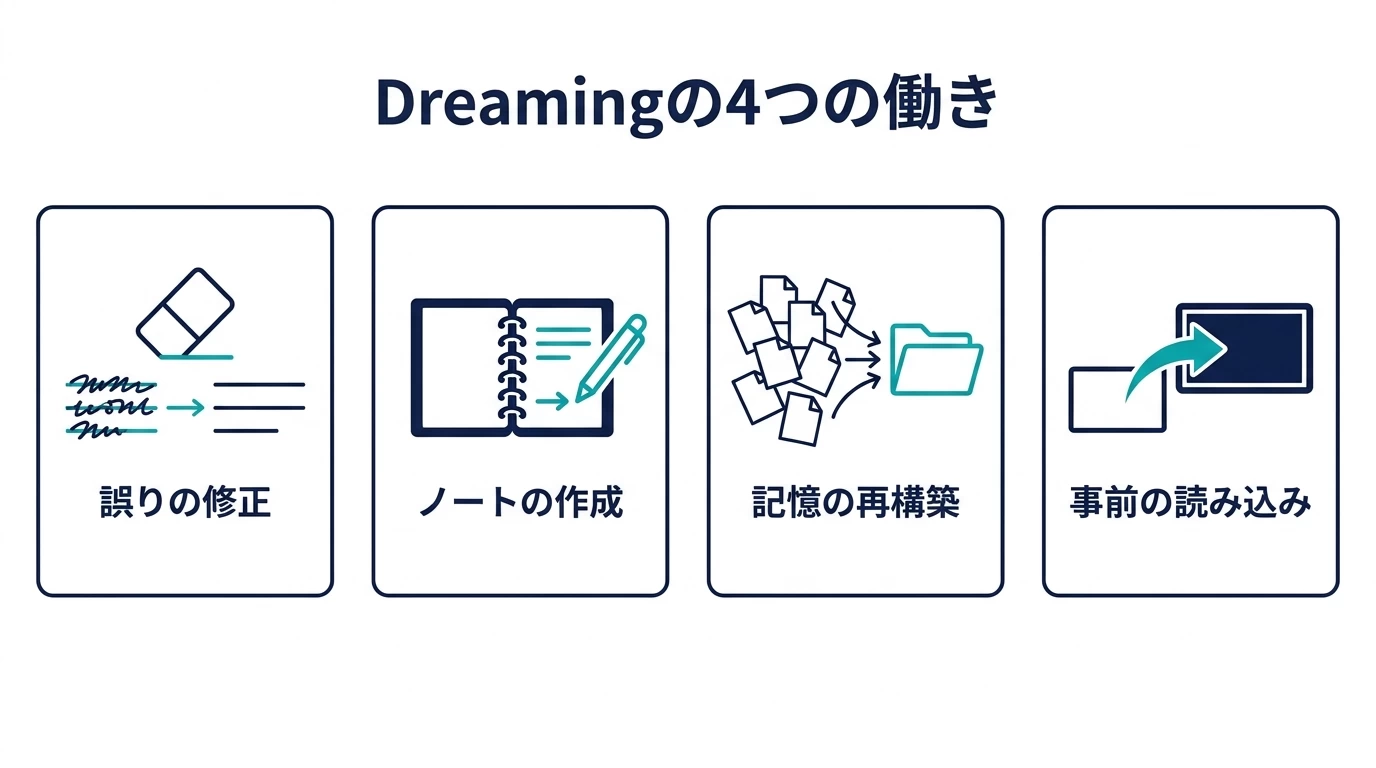
Dreamingの中身を公式資料から整理すると、メモリの誤り修正・ノート作成・新しいメモリ表現の構築・将来セッションへの事前読み込みという4つの働きが柱になっています。これらはいずれも「ためこんだ記録を、そのまま置いておくのではなく、使える形に加工する」という方向性でまとまっています。
▼Dreamingの主な働き
誤りの修正
過去のメモリに事実と異なる内容があれば、気づいた時点で書き換えます
ノートの作成
重要なやり取りや学びを、後から参照しやすいメモとして書き残します
メモリ表現の構築
ばらばらの出来事を、関連づけてひとまとまりの知識として組み立て直します
事前読み込みの準備
次のセッションで最初に読み込む内容を、あらかじめ形作っておきます
これらの処理が行われる背景には、コストの問題があります。GIGAZINEの解説記事によれば、応答のたびに全ての応答履歴を参照すると、処理するトークン数(AIが文章を読み書きする際の処理単位)が増大し、コストや扱えるコンテキストの量を圧迫してしまいます。Dreamingによって重要な情報だけを効果的に記録しておけば、少ないコストで過去の学びを再利用できるというわけです。
つまりDreamingは、派手な「新能力」というより、地道な整理整頓の仕組みに近いといえます。では、この整理によって実際にどの程度の違いが生まれるのか。次の章で、公式が示す検証結果を見ていきます。
どれくらい賢くなる?公式のベンチマーク検証結果
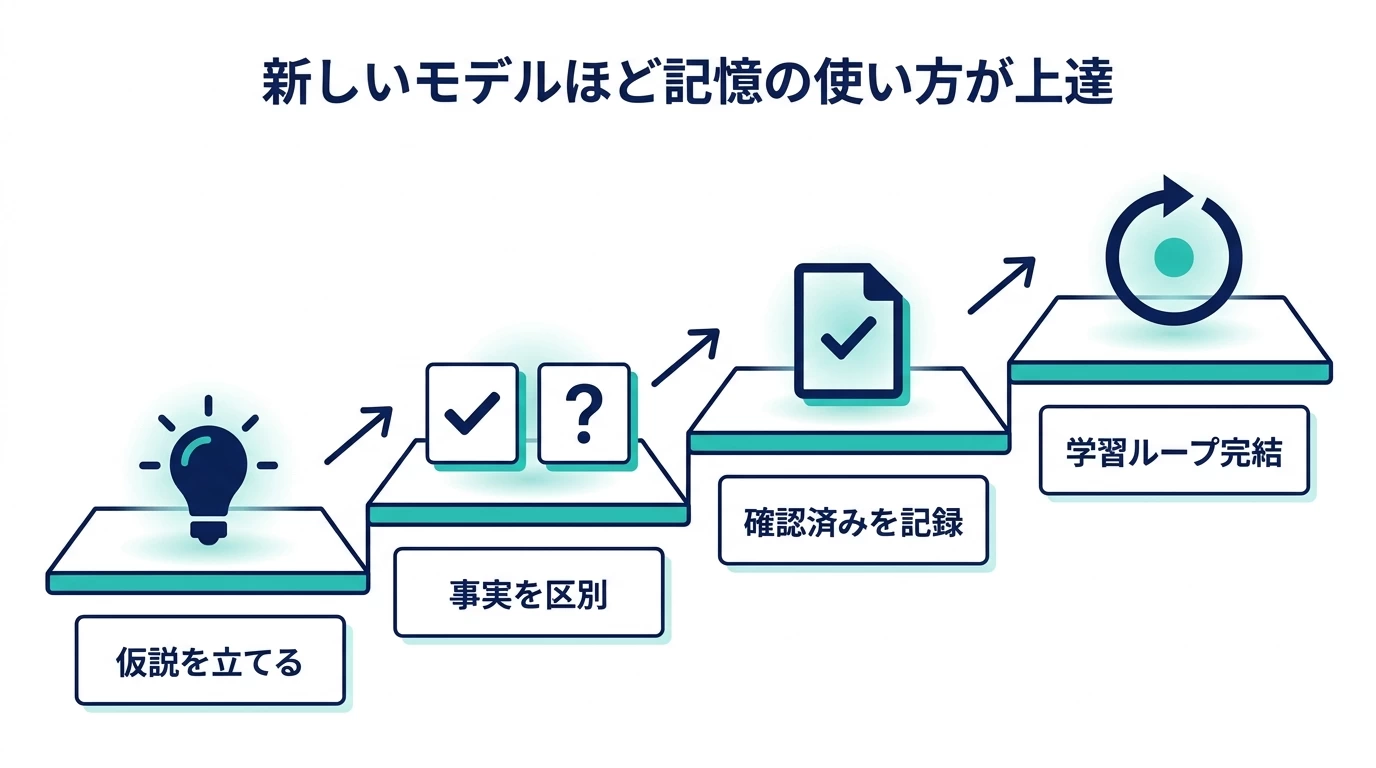
結論から言うと、Anthropicは独自の評価基準でモデルごとの違いを検証し、新しいモデルほどメモリを使った学習の精度が上がっていると説明しています。ここで紹介する数字はすべて、Anthropic自身が公式発表で示した内容です。第三者による独立検証ではない点をあらかじめお断りしておきます。
評価にはContinual Learning Bench(CL-Bench)1.0というベンチマークが使われました。これは、エージェントが長期的なタスクの中でメモリをどう活用するかを測定するテストです。タスクの内容は、Claudeがデータベースを調べて一連の質問に答え、回答後に正解を教えられ、その情報を将来の質問に役立つメモリとして書き込めるというものでした。このテストはClaude Managed Agentsを用いて実施され、Claudeは各質問を新しいセッションとして開始しつつ、セッションをまたいで持続するメモリディレクトリからファイルを取得できる環境で行われています。
モデルごとの違いは、次のように説明されています(会社自身の発表)。
| モデル | メモリ活用の様子(会社自身の発表) |
|---|---|
| Claude Sonnet 4.6 | 間違った答えの理由について仮説を立てる段階まで到達 |
| Claude Opus 4.7 | メモ内容を1つの参照文書にまとめ、確認済みの事実と未確認の事実を区別し始めた |
| Claude Sonnet 5 | 採点者の確認後に各回答を「確認済み」と記録し、誤答時には訂正を書き込んだ |
| Claude Opus 5 | 学習ループを初めて完結させ、ルールと根拠、過去の回答、落とし穴の警告を含むエントリを記録 |
| Claude Opus 5.5 / Sonnet 5.5 | Opus 5と同様に学習ループを完結させ、将来の回答に役立つ検証済みルールを記録 |
興味深いのは、Opus 5.5とSonnet 5.5はメモリ使用時のスコアがOpus 5とほぼ同じだった一方、メモリなしのベースライン性能自体はやや高かったという点です(会社自身の発表)。これは、モデルそのものの素の性能が上がるほど、メモリによる上乗せ効果の見え方が変わってくる可能性を示唆しています。また、Claude Sonnet 4.6はメモリ使用時のスコアの伸びがわずかだった一方、Claude Sonnet 5やOpus 4.7以降のモデルではメモリ使用によるスコアの伸びが大きかったとも報告されています。
もう一つ興味深い検証結果があります。「失敗した試行のみメモリとして記憶せよ」という指示を与えた実験では、Claude Sonnet 4.6は性能低下がわずかだった一方、Claude Opus 5とOpus 4.7では大きく性能が低下したとされています。これは、モデルが高性能になるほど、メモリの使い方そのものが性能に与える影響も大きくなることを示しているといえそうです。
ポケモン実験が示す、メモリの「量」と「質」の違い
数字の中でも特に分かりやすいのが、ゲームを使った検証です。Claude Sonnet 3.7と、より新しいモデルとされるClaude Fable 5(名称は未確認)に『ポケットモンスター 赤』をプレイさせ、メモリの使われ方を比較しています。
| モデル | 9989ステップ時点のメモリ | 達成したジムバッジ数 |
|---|---|---|
| Claude Sonnet 3.7 | 413ファイル・97万7930文字 | 1個 |
| Claude Fable 5(名称は未確認) | 10ファイル・4万3406文字 | 4個 |
この数字の差は象徴的です。Claude Sonnet 3.7のメモリには「所持金」「プレイヤーの位置」のような、ゲーム画面からいつでも取得できる情報まで含まれていました。その結果、1ステップごとに膨大なメモリから必要な情報を絞り込む作業が発生し、かえって進行の妨げになっていたと報告されています。
一方のClaude Fable 5は、現在の目標や攻略計画をまとめた「global.md」というファイルや、ゲームの仕組みについての考察をまとめた「gameplay」というフォルダを作成していました。情報を溜め込むのではなく、必要な形に整理してから持っておくというアプローチが、結果としてゲームの進行速度に直結したというわけです。
Dreamingの効果が分かりやすく出た例として、地名の誤認識の修正があります。Dreamingなしのクロードは「おつきみやまは主人公の背後にある」という誤ったメモリを参照し続け、同じ場所にとどまり続けるパターンが見られました。一方、Dreamingありのクロードはその情報が誤っていることを認識し、メモリを修正してゲームを先に進めることができたとされています。メモリは量より質、というのがこの実験から読み取れる教訓です。
ChatGPTやGeminiのメモリ機能と何が違う?
ChatGPTやGeminiにも、会話の内容を覚えておく記憶機能は備わっています。ただし、Dreamingのように「オフラインの時間を使ってメモリを整理し直す処理」を明確に打ち出しているのは、現時点でのClaudeの特徴といえます。この違いは、各社の記憶機能の立て付けを見比べると分かりやすくなります。
| サービス | 記憶機能の呼び名・特徴 |
|---|---|
| Claude | agent memoryを保存し、Dreamingというオフライン処理で整理・修正する仕組みを公式が明言 |
| ChatGPT | 会話内容を記憶する機能を搭載(他メディアの報道によると整理プロセスの詳細公開は限定的) |
| Gemini | 会話履歴やユーザー設定を踏まえた応答に対応(他メディアの報道によると整理プロセスの詳細公開は限定的) |
他メディアの報道の中には、各社のメモリ機能を横並びで比較した記事もありますが、整理プロセスの技術的な中身まで突き詰めているのはAnthropicの今回の発表が際立っています。どのAIが優れているという話ではなく、「メモリをどう整理するか」を公開情報として踏み込んで説明したかどうかの違いだと捉えるのが実態に近いでしょう。
比較の深掘りはここまでにして、次は「結局、自社の業務にどう関係するのか」を見ていきます。
中小企業の業務にどう関わる?できることと気をつけたいこと
公式が示す範囲で言うと、Dreamingのようなメモリ整理の仕組みは、文章作成・資料づくり・問い合わせ対応・社内の調べものといった業務で、やり取りを重ねるほど精度が上がっていく可能性があります。ただし、これはあくまで技術の仕組みから推測できる可能性であり、具体的な業務での成果が確約されているわけではありません。
想定される活用シーンを挙げると、次のようなものが考えられます。
- 社内ヘルプデスクで、過去に寄せられた質問と回答のやり取りを参照する
- カスタマーサポートで、同じ顧客との過去の対応履歴を踏まえて応答する
- 資料作成で、過去に指摘された修正点を覚えておき、次回以降に活かす
いずれも「AIが過去のやり取りを引き継いで動く」という土台があってこそ成り立つ使い方です。ここで一つ、導入前に押さえておきたいのがリスク面です。
▼導入前に気をつけたい3つの点
機密情報の扱い
やり取りの中に社外秘の情報を含めていないか、事前に社内ルールで確認しておきます
料金・提供範囲の変化
料金体系や機能の提供範囲は時期によって変わるため、都度公式サイトで確認します
モデルの入れ替わり
AIモデルは今後も更新が続くため、特定の1社・1モデルに業務を決め打ちしない体制が望ましいです
弊社はAIの導入と運用を手がける立場として、こうした技術のアップデートを日々追いかけていますが、どの企業にも「これが正解」と言い切れる単一の答えがあるわけではありません。自社の業務にどう組み込むかは、情報の扱い方や社内体制まで含めて考える必要があります。
AI導入を検討する中小企業向け・メモリ機能チェックリスト
Dreamingのようなメモリ機能を自社で活かせるかどうかを判断するには、技術的な理解だけでなく、社内の運用体制まで含めたチェックが欠かせません。次の表を、導入検討の第一歩として使ってみてください。
| チェック項目 | 確認の視点 |
|---|---|
| 社内の機密情報・個人情報をやり取りに含めていないか | メモリに残る可能性がある情報の範囲を事前に確認する |
| 利用プラン(無料・有料)でのメモリ機能の提供範囲 | 公式サイトで契約プランごとの違いを都度確認する |
| 社内でのAI活用ルールが整備されているか | メモリ機能の有無にかかわらず、情報持ち出しのルール化を前提にする |
| 特定のAIモデル・ベンダーに依存しすぎていないか | モデルは今後も入れ替わるため、柔軟に見直せる体制を整える |
| 社内のナレッジ継承に使う場合、属人化の解消につながっているか | ヘルプデスク・引き継ぎ業務での活用可能性を検討する |
このあたりの判断や設計は、弊社のAIコレクション(社内ヘルプデスク・ナレッジ継承向けのオーダーメイドAI)でのご相談でも伺っています。AIの導入を基礎から検討したい方は、AI導入の基本ガイドもあわせてご覧いただくと、全体像がつかみやすくなります。対顧客の問い合わせ対応を自動化したい場合は、AIスミズミのようなチャットボット活用も選択肢に入ってきます。導入コストの目安を先に知りたい方は、チャットボット導入のコスト感をまとめた記事も参考になるはずです。
ここまでDreamingの仕組みと業務への関わり方を見てきました。最後によくある疑問を整理します。
よくある質問(FAQ)
Q1. ClaudeのDreaming機能はいつから使える?
A1. 2026年11月6日にAnthropicが技術解説として公開した内容にもとづく機能説明です。提供時期や対象プランの詳細は変わる可能性があるため、公式サイトで最新情報をご確認ください。
Q2. Dreamingは無料プランでも使える?
A2. 本記事が土台とする一次資料には、料金・プラン別の提供範囲が明記されていません。公式サイトでの最新情報確認をおすすめします。
Q3. Dreamingとメモリ機能は同じもの?
A3. 同じではありません。メモリ機能(agent memory)が保存される知識そのものを指し、Dreamingはそのメモリを整理するプロセスという関係です。
Q4. ChatGPTのメモリ機能と何が違う?
A4. ChatGPTにも会話を記憶する機能はありますが、Dreamingのようなオフライン整理プロセスをここまで明確に説明している点が、現時点でのClaudeの特徴です。
Q5. 社内の機密情報をClaudeに入力しても大丈夫?
A5. 一律に大丈夫とは言い切れません。やり取りの中に社外秘の情報を含めていないか事前に確認し、公式の利用規約と社内ルールの両方を整えたうえで利用することをおすすめします。
Q6. Claude Code(開発者向け)のメモリ機能とDreamingは同じ?
A6. 違うとされています。Claude Codeのメモリ機能は開発プロジェクト固有の知識を記録する仕組みとされ、Dreamingはより広い会話ログ全体を整理するプロセスです(具体的な機能名については公式情報でのご確認をおすすめします)。
まとめ
ClaudeのDreamingは、過去のやり取りを振り返ってメモリを整理し直す仕組みで、公式発表によれば誤りの修正やノートの作成、将来セッションへの事前読み込みといった働きを担います。CL-Benchやポケモン実験の結果からは、メモリは量を増やすより質を整えるほうが成果につながりやすいことが読み取れます。中小企業の業務では、ヘルプデスクや問い合わせ対応での活用が考えられますが、機密情報の扱いやモデルの入れ替わりへの備えは欠かせません。
AIのアップデートは今後も続きます。モデルも機能も変わり続ける中で、自社にとって何が必要か一人で判断するのは正直骨が折れますよね。そんな時は、AI活用の入口を整理したAIサービスのページをのぞいてみるか、一度弊社の無料相談にご相談ください。

コメント