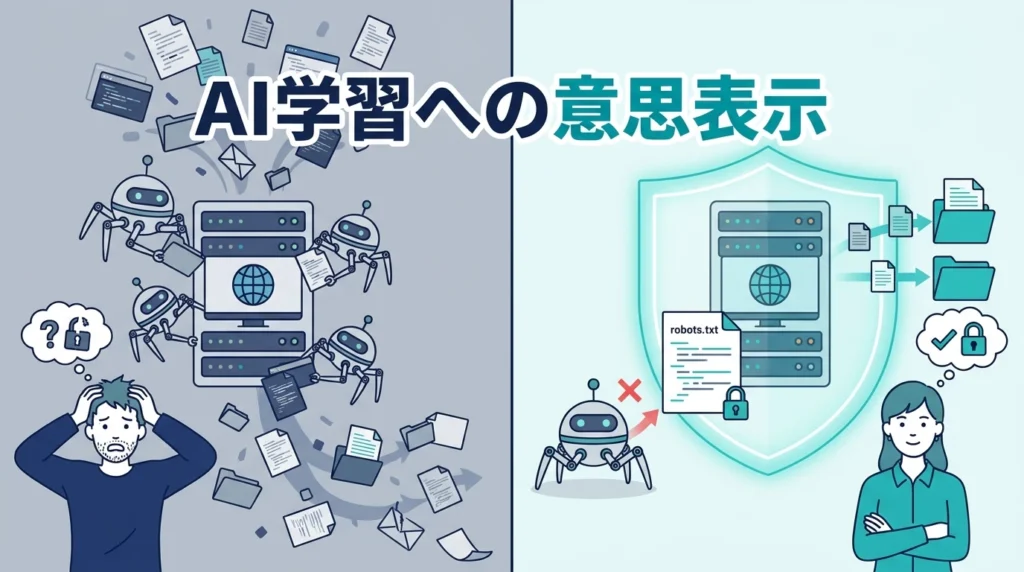
「うちのブログ記事、勝手にAIの学習に使われてるんじゃないか」と気になっていませんか。
OpenAIがrobots.txtの設定を尊重すると発表したニュースを見て、何をすればいいか迷っていませんか。
この記事では、発表の中身と、中小企業の担当者が今日からできる対応を順番に整理します。
難しい専門用語は使う前に必ず説明を添えます。
OpenAIは公式解説記事「Helping websites express AI training preferences」で、Webサイト側がrobots.txt(サイト運営者がクローラーに向けて読み取りの可否を伝えるテキストファイル)で示したAI学習への意思を尊重する方針に言及しているとされています。発表の詳細な時期や適用範囲は変わる可能性があるため、公式情報を都度ご確認ください。「自社サイトは何か変えないといけないのか」という疑問に対する答えを先に言います。設定自体は難しくありませんが、まず自社サイトの現状を知ることが最初の一歩です。
正直に言うと、弊社の実感として、「自社サイトの記事がAIに使われるのは困る」という相談が増えてきています。ただ、相談に来られる担当者の多くは、robots.txtというファイルの存在自体を知らないか、知っていても一度も開いたことがないという状態でした。
この記事では、OpenAIの発表内容、設定の具体的な手順、そして「止めるべきか・止めなくていいか」の判断基準まで、経営者や総務・マーケティング担当の方が読める形でまとめます。
<a href=”https://www.digital-reclame.co.jp/contact/” style=”display:block;padding:14px 20px;background:#f5f8ff;border:1px solid #c9d8f5;border-radius:8px;text-decoration:none;color:#1a3b8f;font-weight:bold;”>自社サイトのAI対応に不安がある方は、設定の前に一度ご相談ください →無料相談はこちら</a>
OpenAIは何を発表したのですか?
OpenAIは、Webサイト運営者がrobots.txtに記述した内容を、AIモデルの学習データ収集の判断に反映させる方針を明らかにしました。つまり、サイト側が「学習に使わないでほしい」という意思をrobots.txtで示せば、その意思を考慮する、という内容です。
この発表は、OpenAIの公式解説記事で確認できます。記事タイトル「Helping websites express AI training preferences」は、直訳すると「Webサイトがウェブサイトの学習に関する希望を表明する手助けをする」という意味です。
発表の経緯を簡単に整理すると、次のようになります。
- Webサイト運営者が、AIの学習データとして自社コンテンツを使われたくないという声が増えていた
- robots.txtはもともと検索エンジンのクロール制御のために使われてきたファイルで、AI学習の意思表示としての扱いは事業者ごとにばらつきがあった
- OpenAIが、robots.txtの記述をAI学習データ収集の判断材料として尊重する方針を公式に表明した
なお、発表の詳細な適用範囲や細かい運用ルールについては、公式ページの更新状況を都度確認することをおすすめします。AIサービスの仕様は変わりやすく、発表時点の内容がそのまま継続するとは限らないためです。
どこで・誰が使える機能ですか?料金はかかりますか?
結論から言うと、Webサイトを運営している事業者であれば、誰でもこの仕組みの対象になります。追加の契約やOpenAIへの申請といった手続きは必要なく、robots.txtというファイルを自社サーバーに置くだけです。
費用についても、robots.txtの記述自体に料金は発生しません。これはもともとWeb標準の技術であり、OpenAI向けの有料オプションではないためです。
| 項目 | 内容 |
|---|---|
| 対象 | Webサイトを運営するすべての事業者 |
| 必要な作業 | robots.txtへの記述(クローラー名を指定して許可・拒否を書くだけ) |
| 費用 | 追加費用は発生しない(Web標準の無料の仕組み) |
| 確認方法 | 自社ドメイン+「/robots.txt」にブラウザでアクセスして現状を見る |
まずは自社サイトの状況を確かめるところから始めましょう。ブラウザのアドレスバーに「自社ドメイン/robots.txt」と入力するだけで、現在の設定が表示されます。何も表示されない、あるいはファイルが存在しない場合は、まだ何の意思表示もしていない状態ということになります。
robots.txtとは何ですか?
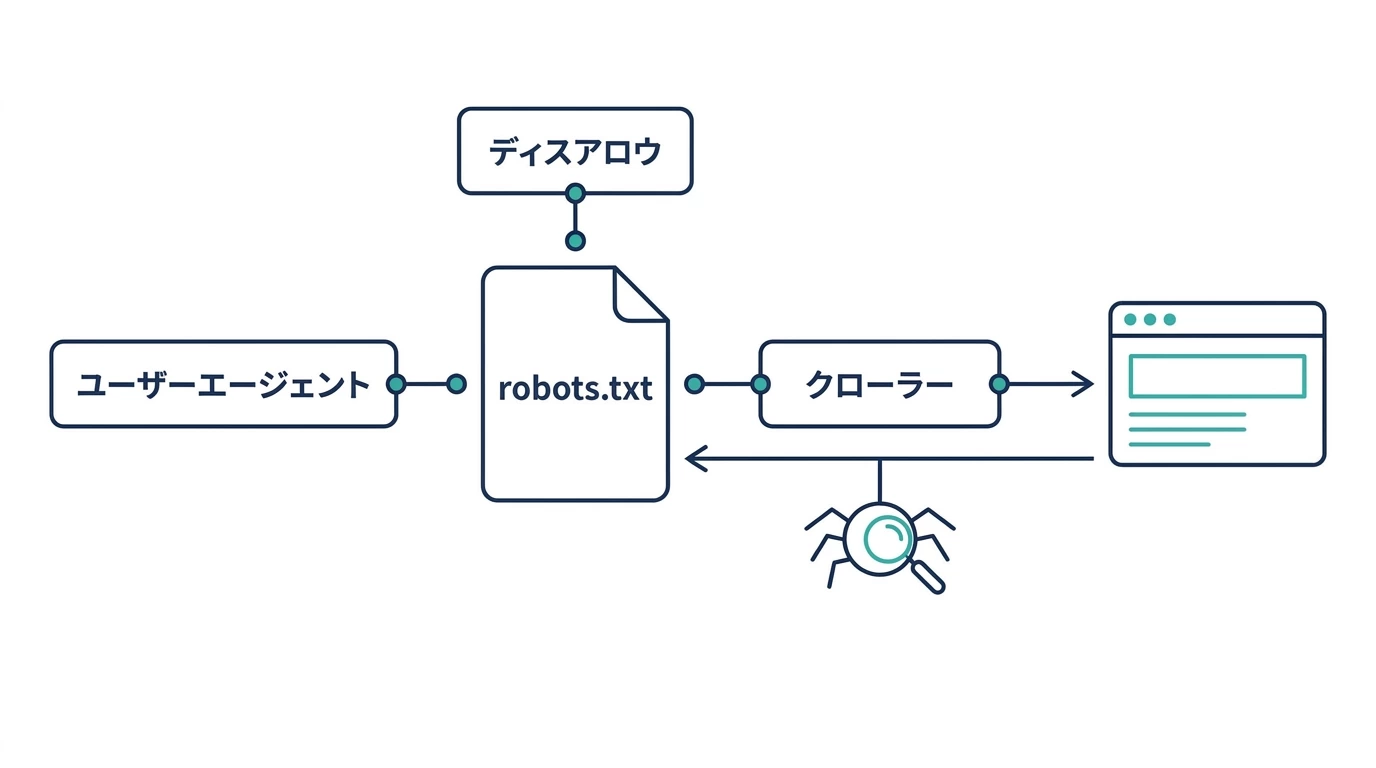
robots.txtとは、検索エンジンやAIのクローラー(Webサイトを自動で巡回して情報を収集するプログラム)に対して、サイトのどの部分を読み取ってよいかを伝えるテキストファイルです。サイトのトップ階層に置かれ、クローラーが訪問時に最初に確認する仕組みになっています。
記述の中でよく出てくる用語を、ここで平易に説明しておきます。
- User-agent(ユーザーエージェント):どのクローラーに向けた指示かを示す部分です。「GPTBot」のようにクローラーの名前を書きます
- Disallow(ディスアロウ):読み取りを拒否する範囲を示す指示です。「/」と書くとサイト全体が対象になります
- クローラー:検索エンジンやAI事業者がWebサイトの情報を自動収集するために使うプログラムの総称です
robots.txtはもともと検索エンジンのクロール制御のために考案された仕組みで、長い歴史があります。AI学習データの収集にも同じ仕組みが応用されるようになった、というのが現在の流れです。
ここまでが基本的な仕組みの説明です。
自社サイトのAI学習設定は、どう書けばいいですか?
WordPressを使っているサイトであれば、数行の追記で設定できます。専門的なプログラミングの知識は必要ありません。
まず、代表的なAI事業者のクローラー名と、学習を拒否する場合の記述例を整理します。
| クローラー名(AI事業者) | 役割 | 学習を拒否する記述例 |
|---|---|---|
| GPTBot(OpenAI) | AIモデルの学習データ収集 | User-agent: GPTBot<br>Disallow: /(クローラー名は変更・追加される場合があるため、設定前に公式情報をご確認ください) |
| ClaudeBot(Anthropic) | AIモデルの学習データ収集 | User-agent: ClaudeBot<br>Disallow: /(クローラー名は変更・追加される場合があるため、設定前に公式情報をご確認ください) |
| meta-externalagent(Meta) | AIモデルの学習データ収集 | User-agent: meta-externalagent<br>Disallow: /(クローラー名は変更・追加される場合があるため、設定前に公式情報をご確認ください) |
▼WordPressでの設定の進め方
プラグイン利用
SEOプラグインにrobots.txtの編集機能が付いている場合があり、その場合は管理画面から直接書き換えられます。
FTP・サーバー管理画面経由
レンタルサーバーのファイル管理機能やFTPソフトで、サイトのルート階層に robots.txt ファイルを直接アップロードします。
反映確認
設定後は自社ドメイン+「/robots.txt」に改めてアクセスし、記述が反映されているかを確認します。
設定を迷う場合は、まず自社のドメインで「/robots.txt」を開いて、現状どうなっているかを把握するところから始めてください。何もない状態から始める方が、途中から変更するより判断しやすいです。
設定方法は分かったものの、「自分で対応する時間がない」という方は、AIサービスのページから相談いただくことも可能です。
設定しても完全に防げるわけではない、という注意点
robots.txtは、あくまでクローラーに対する「お願い」であり、法的な強制力や技術的な遮断効果を持つものではありません。この点は誤解しやすいため、はっきり伝えておきます。
一部のAI事業者がrobots.txtの除外指示を十分に遵守していないのではないかという声も見られます。出典や具体的な事業者名を確かめられる情報ではありませんが、robots.txtだけに頼り切らない方がよいという現実的な示唆として捉えておくとよいでしょう。
正直なところ、robots.txtを設定したからといって「100%学習されない」と保証されるわけではありません。善意あるクローラーの巡回を制御する仕組みであり、それ以上でもそれ以下でもない、という理解が適切です。
自社サイトは学習させるべき?止めるべき?
判断の軸はシンプルで、「サイトの価値が文章そのものにあるか」「見つけてもらうことが目的か」の2択で考えると整理しやすくなります。
▼止める・止めないを分ける2つの軸
文章そのものに価値があるか
独自調査や専門的な見解など、文章がそのままコピーされると価値が目減りするコンテンツかどうかで判断します。
見つけてもらうことが目的か
会社の存在や商品を知ってもらうためのページは、AIに引用されることがむしろプラスに働く場合があります。
具体的な分類は次のとおりです。
止めたほうがよいサイト・ページの例
- 時間をかけて行った独自調査やアンケート結果の記事
- 会員限定で提供しているノウハウや有料級の解説コンテンツ
- 士業・コンサルタントが専門知識を体系化して公開している解説記事
止めなくてもよいサイト・ページの例
- 会社案内や代表挨拶など、認知を広げる目的のページ
- 商品・サービスの紹介ページ
- 店舗の所在地や営業時間などの基本情報
中小企業のサイトに当てはめると、オウンドメディア(自社で運営するブログやコラム)の独自取材記事は止める候補になりやすく、採用ページやサービス紹介ページはむしろ見つけてもらいたいので止めない候補になります。すべてを一律に止めるのではなく、ページの種類ごとに考えるのが現実的です。
中小企業の担当者が注意すべきことは?
自社で制作した記事だけでなく、外部に依頼した原稿や素材の扱いにも目を向ける必要があります。業務委託契約を結んだ時点では、AI学習への提供までは想定していなかったケースが多いためです。
- 業務委託契約・ライター契約の確認:外部ライターに執筆を依頼した記事や、素材サイトから購入した画像について、著作権の扱いやAI学習への提供可否が契約書に明記されているか見直します
- 1社の設定だけに依存しない運用:GPTBot以外にも複数のAI事業者のクローラーが存在するため、特定の1社だけを対象にした設定で満足しないようにします
- 定期的なrobots.txtの見直し:AI事業者のクローラーは今後も新しく登場する可能性があるため、半年に一度程度は記述内容を見直す習慣をつけておくと安心です
生成AIの台頭に伴い、サイトを巡回するクローラーの数は一般的に増加傾向にあるとされています。数も種類も増えていく前提で、運用ルールを柔軟に見直せる体制を作っておくことが現実的な備えになります。
ここで、自社サイトの状況を一度整理するためのチェックリストを用意しました。
▼自社サイトのAI学習設定・確認チェックリスト
現状確認
自社ドメイン+「/robots.txt」にアクセスして、今の設定を確認します。
価値の整理
サイトの価値が「文章そのもの」か「見つけてもらうこと」かを整理します。
契約の確認
外部ライターや素材サイトとの契約内容にAI学習への提供可否が触れられているか確認します。
クローラーの確認
GPTBot・ClaudeBot・meta-externalagentなど、主要クローラーの記述の有無を確認します。
反映の確認
設定を変更したら、再度「/robots.txt」にアクセスして反映されているか確認します。
弊社の実感としても、robots.txtというファイルの存在すら知らなかったという担当者は少なくありません。難しい話ではなく、まず「見てみる」ことから始めるだけで、現状把握は十分に進みます。
弊社の考え
弊社はAIの導入・運用支援を手がける立場として、robots.txtの設定は「難しい技術対応」ではなく「自社の情報方針を言語化する作業」だと捉えています。どの情報を外に出し、どの情報を手元に残すか、改めて考えるきっかけとして捉えるのが実務的です。
robots.txtの記述そのものは数行で終わりますが、その前段階にある「自社サイトの何が価値の源泉なのか」という整理こそが本質的な作業です。この整理ができていれば、今後新しいAI事業者が登場しても、同じ考え方で対応を判断できます。
AIとの向き合い方は、設定作業だけでなく、社内の情報管理や業務フロー全体に関わるテーマです。社内のAI活用や情報管理の全体像を相談したい場合は、AIサービスのページで取り扱っている内容もあわせてご確認ください。顧客対応の自動化に関心がある方は、AIスミズミのページも参考になります。
AI導入そのものを検討している段階の方には、AI導入ガイドの記事もあわせてご覧いただくと、全体像がつかみやすくなります。問い合わせ対応の自動化を具体的に検討している場合は、チャットボットの費用相場をまとめた記事も参考にしてください。
よくある質問(FAQ)
Q1. robots.txtを設定すれば、AIに絶対に学習されませんか?
いいえ、robots.txtには法的な強制力がなく、あくまでクローラーへの「お願い」です。善意あるクローラーの巡回を制御する仕組みであり、100%の遮断を保証するものではありません。
Q2. robots.txtの設定に、専門知識やエンジニアは必要ですか?
専門知識がなくても対応できます。WordPressならSEOプラグインの管理画面から数行追記するだけで設定でき、FTP経由でも同様に簡単です。
Q3. すでに公開済みの記事も、AIの学習データから削除できますか?
過去に収集済みのデータについては、オプトアウト申請の仕組みを案内しているAI事業者もあるとされています。対応範囲は事業者ごとに異なるため、不明な点は推測せず公式の案内を都度確認することをおすすめします。
Q4. GPTBot以外にも拒否すべきクローラーはありますか?
ClaudeBot(Anthropic)やmeta-externalagent(Meta)など、主要なAI事業者ごとにクローラー名が異なります。必要に応じて同じ書式で記述を追加していく考え方で問題ありません。
Q5. robots.txtの設定は、SEO(検索順位)に影響しますか?
AI学習用クローラーの制御と、検索エンジンのクロール制御は別物として扱われます。GoogleBot向けの設定を誤って変更すると検索順位に影響するため、記述を分けて管理してください。
Q6. 一度設定したら、そのままで大丈夫ですか?
いいえ、AI事業者のクローラーは今後も増えたり変わったりする前提で考える必要があります。半年に一度程度を目安に、robots.txtの内容を見直す習慣をおすすめします。
まとめ
OpenAIがrobots.txtの記述を学習データ収集の判断に反映させる方針を明らかにしたことで、Webサイト運営者が自社の意思を示せる手段が明確になりました。設定自体は数行の追記で済み、専門知識がなくても対応できます。
大切なのは、設定の前に「自社サイトの価値がどこにあるか」を整理すること。文章そのものに価値があるコンテンツと、見つけてもらうことが目的のページとでは、判断が変わってきます。
robots.txtは万能の防御策ではありませんが、何もしないよりは自社の意思を明確にできる手段です。まずは自社ドメインの「/robots.txt」を確認するところから始めてみてください。
AIとの付き合い方を含めて相談したい方は、AIサービスのページで弊社の取り組みをご確認いただけます。設定の判断に迷う、あるいは社内の情報管理まで含めて相談したいという方は、無料相談からお気軽にお問い合わせください。

コメント