ChatGPTのニュースで「LLM」という言葉を見たけれど、結局何なのかよく分からない。
GPT・Gemini・Claudeの違いや、生成AIとの違いを聞かれても、正直うまく説明できない。
そんな状態のまま、社内でAI活用の話だけが進んでいませんか。
この記事では、LLMの意味と仕組み、種類、生成AIやChatGPTとの違い、業務での使い方、自社のデータで精度を上げる方法、注意すべきリスクまでを順番に解説します。
弊社はAIチャットボットの提供や、社内ツールへのAI組み込みを日々行っています。一般的な説明に加えて、弊社が実際にLLMを業務でどう使い、どこでつまずいたかも具体的にお伝えします。
LLMとは?一言でいうと何なのか【結論】
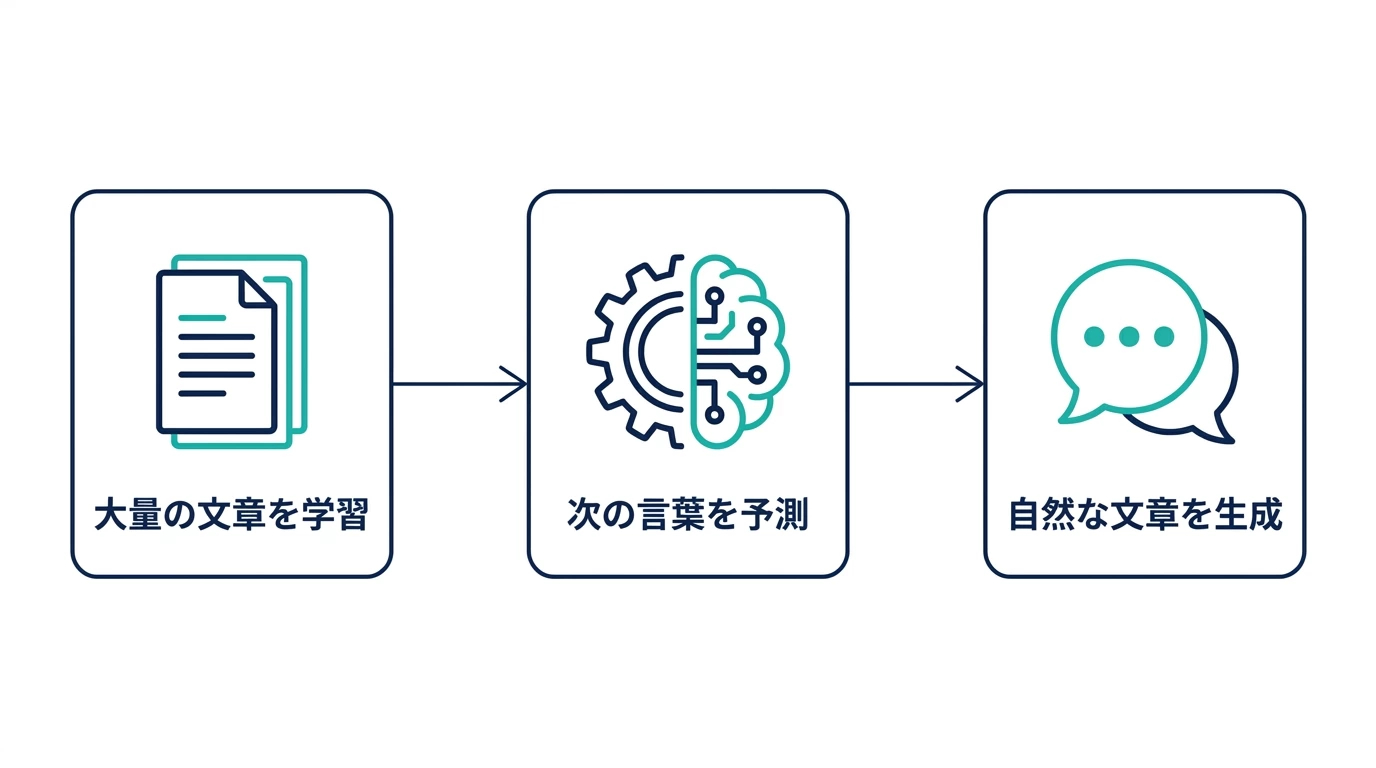
LLM(Large Language Model=大規模言語モデル)とは、膨大な量の文章データを学習して、人間のような自然な文章を理解・生成できるAIの仕組みです。一言でいえば「大量の文章から言葉のつながり方を学び、次に来る言葉を確率で予測しながら文章を作る技術」です。読み方は「エルエルエム」です。
ChatGPTやGemini、Claudeといった対話AIサービスは、このLLMを中核にして作られています。LLMはサービスの内部で動いている仕組みの名前で、ChatGPTはその仕組みを使った製品、という関係です。
たとえば「明日の天気は」という文章の後には「晴れ」や「雨」が来やすい、といった言葉のつながりの傾向を、LLMは膨大な文章から学んでいます。この予測を一語ずつ繰り返すことで、質問への回答、文章の要約、翻訳、メールの下書きなどができるようになります。
何が「大規模」なのか
LLMの「大規模」は、従来の言語モデルと比べて次の3つが桁違いに大きいことを指します。
| 大規模になったもの | 意味 |
|---|---|
| 学習データの量 | Webサイト・書籍・論文など、学習に使う文章の量 |
| 計算量 | 学習や文章の生成にかける計算の量 |
| パラメータ数 | モデルの中で、言葉のつながりを表すために調整される数値の数。数十億〜数千億規模のものもあります |
データと計算とパラメータを増やすほど予測の精度が上がる傾向があることが分かり、この「大規模化」によって、人間に近い自然な会話や文章の生成ができるようになりました。
LLMはなぜここまで注目されているのか?
LLMが急に広まった背景には、主に次の4つがあります。
- Transformerの登場:2017年にGoogleの研究者が発表した「Transformer」という仕組みにより、文章全体を一度に見比べて学習できるようになり、学習の効率が大きく上がりました
- 誰でも使えるサービスの登場:2022年11月にChatGPTが公開され、専門知識がなくてもブラウザから話しかけるだけで使えるようになりました
- 計算機の性能向上:GPUなど、大量の計算を並列でこなす機械が手に入りやすくなりました
- 学習データの増加:インターネット上の文章が増え、質の高いデータを大量に集められるようになりました
以前のAIは「決められたルールに沿って答える」ものが中心でした。LLMは文章のパターンそのものを学ぶため、あいまいな質問や言い換えにも柔軟に答えられます。この使いやすさが、業種を問わず広まった一番の理由です。
LLMはどんな仕組みで動いているのか?
LLMの動き方は、大きく「学習」と「推論(文章の生成)」の2段階に分けられます。学習で膨大な文章から言葉のパターンを覚え、推論でその知識をもとに次の言葉を予測しながら文章を作ります。
学習:事前学習と追加の調整
最初に行うのが「事前学習」です。インターネット上の文章や書籍などを読み込ませ、「ある言葉の次にどの言葉が来やすいか」を予測する練習を大量に繰り返します。正解を人が付ける必要がない「自己教師あり学習」という方法で行うため、膨大なデータを使えます。
事前学習だけのモデルは、知識はあっても質問への答え方が安定しません。そこで、質問と模範回答の例で追加学習させる「ファインチューニング」や、人が回答の良し悪しを評価してその結果で調整する「人間のフィードバックによる強化学習(RLHF)」を行い、役に立つ答え方に整えます。
この学習を可能にしているのがTransformer(トランスフォーマー)です。文章の中のどの単語とどの単語が関係しているかを同時に見比べる仕組みで、たとえば「彼はパンを買った。それを食べた」という文章であれば、「それ」が「パン」を指していることを、離れた位置にある単語同士の関係から読み取ります。
推論:文章が作られるまでの5つのステップ
質問を入力してから回答が返ってくるまで、LLMの中では次の処理が行われています。
▼LLMが文章を作るまでの5つのステップ
トークン化
入力された文章を「トークン」と呼ばれる小さな単位に分けます。たとえば「AIを利用する」は「AI」「を」「利用」「する」のように分けられます。
ベクトル化
各トークンを、意味を表す数値の並び(ベクトル)に変換します。「犬」と「猫」のように意味が近い言葉は、数値の上でも近い位置に置かれます。
文脈の理解
「セルフアテンション(自己注意)」という仕組みで、文章中の言葉同士がどれくらい関係しているかを計算します。「銀行でお金を引き出した」の「銀行」が金融機関であることを、周りの言葉から判断します。
次の言葉の予測
ここまでの情報をもとに、次に来る可能性が高いトークンを選びます。
文章の組み立て(デコード)
選んだトークンを文章に足し、また次のトークンを予測する、という処理を繰り返して文章を完成させ、人が読める文字に戻します。
最後の予測の段階では、「温度(temperature)」という設定で、毎回ほぼ同じ答えを返すか、表現にばらつきを持たせるかを調整できます。社内文書の要約のように正確さが大事な用途では低め、アイデア出しでは高めにするのが一般的です。
LLMは「意味を理解して考えている」わけではなく、学んだパターンから最もありそうな言葉を選び続けています。この性質が、後で説明するハルシネーション(もっともらしい誤り)の原因にもなっています。
LLMにはどんな種類がある?GPT・Gemini・Claudeの違いは?
代表的なLLMには、開発元ごとに異なる特徴があります。自社で使う際は、日本語の精度・APIの使いやすさ・費用・データの扱いのバランスを見て選ぶのが基本です。
| モデル名 | 開発元 | 特徴 | 主な利用形態 |
|---|---|---|---|
| GPTシリーズ | OpenAI | 汎用性が高く、対話が自然 | ChatGPT、API経由で業務システムへの組み込み |
| Gemini | GmailやGoogleドキュメントなど、Googleのサービスとの連携が強み | Geminiアプリ、Google Workspace、API | |
| Claude | Anthropic | 長い文書の読み込みが得意で、安全性を重視した設計 | Claudeアプリ、API経由での文書の要約・分析 |
| Llama | Meta | モデルの中身(重み)が公開されており、自社の環境で動かせる | 自社サーバーでの運用、追加学習 |
各シリーズとも新しい版が短い間隔で出ており、性能や料金もそのたびに変わります。具体的な版や料金は、導入を決める前に各社の公式ページで確認してください。
オープン型LLMと商用型LLMの違い
LLMは大きく、モデルの中身が公開されていて自由に動かせる「オープン型」と、企業がAPIやアプリとして提供する「商用型(独自開発型)」に分かれます。
| 比べる点 | オープン型(例:Llama、Gemmaなど) | 商用型(例:GPT、Gemini、Claude) |
|---|---|---|
| 使い始めやすさ | 環境の構築が必要で、専門知識がいる | APIやアプリですぐ使える |
| 費用のかかり方 | 計算機の用意と保守に費用がかかる。使う量が多いほど割安になりやすい | 使った量に応じて利用料がかかり続ける |
| データの扱い | 自社の環境から外に出さずに処理できる | 外部のサービスに送るため、規約の確認が必要 |
| カスタマイズ | 自社データで追加学習しやすい | 提供されている範囲で調整する |
| 性能の更新 | 新しい版への入れ替えは自分で行う | 提供側が更新してくれる |
商用型は、提供側がモデルの提供を終了したり入れ替えたりすることがあり、それに合わせて自社の仕組みを直す手間が出ることがあります。反対にオープン型は長く同じモデルを使い続けられますが、保守の手間は自社で負うことになります。
日本語に強いLLMの現状
LLMの多くは英語を中心に開発されてきましたが、日本語は文の構造や敬語、漢字・ひらがな・カタカナの混在など、英語と大きく異なる特徴があります。海外の主要モデルも日本語の精度は大きく上がっていますが、国内でも日本語に特化したモデルの開発が進んでいます。
| モデル | 開発元 | 特徴(公式発表より) |
|---|---|---|
| tsuzumi 2 | NTT | 2025年10月提供開始。1枚のGPUで動く軽さと日本語性能を両立し、金融・医療・公共分野の知識を強化 |
| cotomi | NEC | 日本語の処理精度と速度を重視した企業向けモデル |
| Takane | 富士通(Cohereと共同開発) | 2024年9月提供開始。企業専用の環境で使え、自社データでの追加学習に対応 |
| Swallow | 東京科学大学・産業技術総合研究所 | 海外のオープン型モデルを日本語で追加学習させたモデルのシリーズ。公開されており研究・商用で使えるものがある |
日本語に特化したモデルは、社外にデータを出せない業務や、専門用語の多い業務で検討されることが多いです。一方、一般的な文章作成や要約であれば、海外の主要モデルでも十分な品質が出ることが増えています。実際の業務文書で試して比べるのが確実です。
ローカルLLM(自社の環境で動かすLLM)のメリット・デメリット
ローカルLLMとは、外部のクラウドを使わず、自社のサーバーやパソコンの中でLLMを動かす使い方です。最近は小さく軽いモデルの性能が上がり、ノートパソコンで動くものも出てきました。
| 内容 | |
|---|---|
| メリット①データの安全性 | 社外にデータを送らないため、機密情報や個人情報を扱う業務で使いやすい |
| メリット②通信に左右されない | インターネットの混雑やAPIの待ち時間の影響を受けにくい |
| メリット③大量利用の費用 | 使う量が非常に多い場合、API利用料より安くなることがある |
| デメリット①機材と知識が必要 | 大きなモデルほど高性能なGPUと大容量のメモリが必要で、構築と保守に専門知識がいる |
| デメリット②性能の差 | 自社の機材で動く規模のモデルは、最新の大規模な商用モデルより性能が落ちることが多い |
| デメリット③更新と管理の手間 | 新しい版への入れ替えや安全対策を自社で行う必要がある |
なお、パラメータ数を抑えて特定の用途に絞った小型のモデルは「SLM(小規模言語モデル)」と呼ばれることもあります。ローカルで動かす場合は、こうした小型モデルと、量子化(計算に使う数値の精度を下げて軽くする技術)や蒸留(大きなモデルの振る舞いを小さなモデルに学ばせる技術)を組み合わせるのが一般的です。
LLMと生成AI・ChatGPT・機械学習は何が違う?
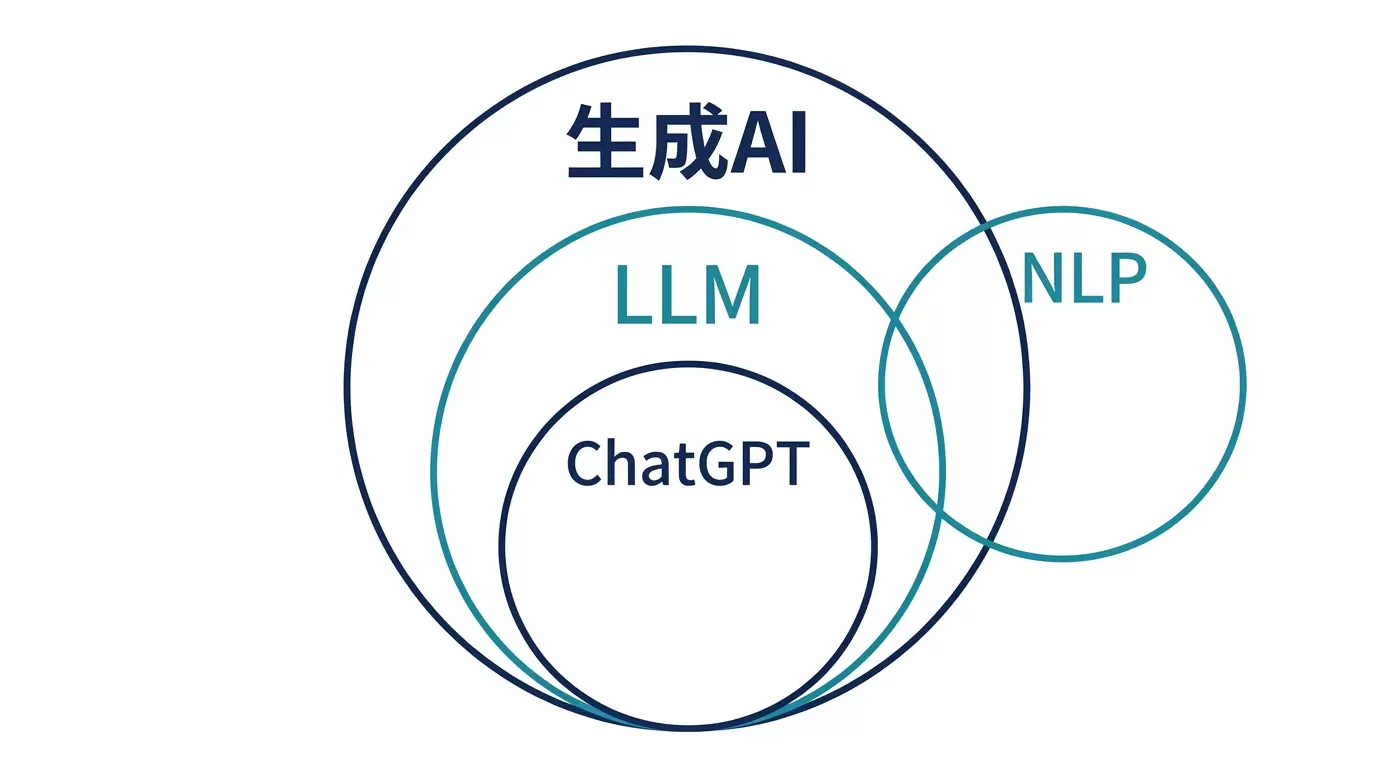
生成AIは「文章・画像・音声・動画などを作り出すAI全般」を指す広い言葉で、LLMはその中でも「文章(言語)に特化した仕組み」です。ChatGPTはLLM(GPT)を使って作られた対話サービスの名前、という関係になります。
似た言葉が多いので、関係を表で整理します。
| 用語 | 意味 | LLMとの関係 |
|---|---|---|
| AI(人工知能) | 人の知的な作業をコンピューターで行う技術全体 | LLMはAIの一分野 |
| 機械学習 | データからパターンを学んで予測や分類を行う技術 | LLMは機械学習の一種 |
| ディープラーニング(深層学習) | 人の脳の神経回路をまねた多層のネットワークで学習する、機械学習の方法 | LLMはディープラーニングで作られている |
| NLP(自然言語処理) | 人の言葉をコンピューターで扱う技術分野全体 | LLMはNLPの中で近年急速に発展した技術 |
| 生成AI | 文章・画像・音声などを新しく作り出すAI全般 | LLMは文章を作る生成AIの中核 |
| 言語モデル(LM) | 言葉の並びの確率を表すモデル。小さなものも含む | LLMは言語モデルを大規模にしたもの |
| ChatGPT・Gemini・Claude(アプリ) | LLMを使った対話サービス | LLMの使い道の一つ |
たとえば画像生成AIの多くは、ノイズから少しずつ画像を作る「拡散モデル」という別の仕組みで動いており、生成AIではあってもLLMではありません。また、Microsoftの「Copilot」は、LLMを使って同社のOfficeやWindowsの中で文章作成などを手伝うサービスで、これもLLMを使った製品の一つです。
「AIモデル」という言葉もよく一緒に使われますが、これは予測や生成を行う仕組み全般を指す、さらに広い言葉です。画像を分類するモデルも、売上を予測するモデルも「AIモデル」であり、LLMはその中の文章特化型という位置づけです。
LLMは業務で何ができる?代表的な6つの使い道
LLMは文章に関わる作業の多くをこなせます。代表的な使い道は次の6つです。
| 使い道 | 具体例 |
|---|---|
| 文章の作成 | メール、報告書、商品の紹介文、ブログ記事の下書き、SNS投稿の案 |
| 要約 | 長い資料・議事録・調査レポートの要点を、「3行で」「箇条書きで」など指定した形でまとめる |
| 翻訳 | 専門用語や言い回しのニュアンスを踏まえた翻訳、海外向け資料の作成 |
| プログラムの作成 | 自然な言葉の指示からのコード作成、不具合の原因と直し方の提案 |
| 対話(チャットボット) | お客様からの問い合わせや社内の質問への自動応答 |
| 複数の種類の情報の処理 | 画像・図表・音声なども合わせて読み取る(マルチモーダル対応のモデルの場合) |
中小企業でよくあるLLM活用シーン
中小企業では、「社内ナレッジの検索・回答」「問い合わせ対応の下書き」など、決まった形の文章業務から始めると効果を感じやすいです。人手で何時間もかけていた作業を、下書きの段階まで一気に進められます。
▼中小企業でよくあるLLM活用シーン
社内ヘルプデスク
よくある質問への回答をAIが代わりに行い、担当者の負担を減らします。
ナレッジの引き継ぎ
退職者の知見や過去の対応履歴をまとめ、誰でも検索できるようにします。
議事録作成
会議の録音から要点をまとめ、共有用の議事録に整えます。
問い合わせ対応の下書き
お客様からのメールやチャットへの返信文案を作ります。
社内ヘルプデスクへの活用は、問い合わせが特定の社員に集中している会社で効果が出やすい分野です。経理のルールや就業規則など、同じ質問が何度も来る業務ほど、LLMに任せる効果が出やすくなります。
ナレッジの引き継ぎも大切なテーマです。ベテラン社員が退職すると、その人にしか分からない判断基準が失われることは中小企業では珍しくありません。過去のやり取りやマニュアルをLLMから参照できるようにしておけば、新しく入った社員でも同じ水準の回答を引き出せるようになります。
大企業ではどこまで進んでいるか
大企業では全社規模での活用が進んでいます。たとえばパナソニック コネクトは、全社員向けのAIアシスタントの活用により、2025年度に年間78.8万時間(総労働時間の3.4%)の業務時間を削減したと公式に発表しています。使い方が「質問する」から「作業を頼む」へ移ったことで効果が大きくなったとしています。
業界別では、次のような使われ方が増えています。
- 医療:論文や診療ガイドラインの要約、患者さん向け説明文の下書き(最終判断は必ず医師が行う)
- 教育:教材や練習問題の作成、学習者の質問への個別の回答
- カスタマーサポート:問い合わせへの一次回答、対応履歴の要約、オペレーターへの回答案の提示
- 保険・金融:社内規程や商品資料を参照した照会応答、書類の確認
- 建設・製造:社内の技術資料や過去の事例を検索できるようにし、若手への技術の引き継ぎに使う
自社のデータでLLMの精度を上げる4つの方法
LLMは一般的な知識は豊富ですが、自社の商品・社内ルール・最新の情報は知りません。自社の業務で使うには、次の4つの方法を組み合わせます。上から順に手軽で、下に行くほど手間と費用がかかります。
| 方法 | 内容 | 必要なもの | 向いている場面 |
|---|---|---|---|
| プロンプトの工夫 | 指示文の書き方を工夫して、望む答えを引き出す | 特になし | まず最初に試す。どの業務でも基本 |
| RAG(検索拡張生成) | 質問のたびに社内文書などから関係する部分を探し、LLMに渡して答えさせる | 社内文書・Webページなどの資料 | 社内規程や商品情報など、内容が更新される情報を答えさせたい |
| ファインチューニング | 自社のデータで追加学習させ、モデル自体を調整する | 質問と回答の例など数千件規模のデータと計算費用 | 専門用語や決まった文体・形式で安定して答えさせたい |
| 事前学習から作る | モデルを一から学習させる | 膨大なデータと非常に大きな計算資源 | 大企業や研究機関向け。中小企業ではほぼ選ばない |
中小企業の業務では、ほとんどの場合「プロンプトの工夫」と「RAG」で目的を達成できます。ファインチューニングは費用と手間がかかるため、この2つで足りないと分かってから検討するのが順当です。
プロンプトの工夫(プロンプトエンジニアリング)
プロンプトエンジニアリングとは、LLMへの指示文(プロンプト)を工夫して、望む回答を引き出す技術です。同じ質問でも、書き方を少し変えるだけで、回答の詳しさや文章の調子、正確さが大きく変わります。
たとえば「猫について教えてください」という指示よりも、「初めて猫を飼う人向けに、飼い方の注意点を3つ、箇条書きで説明してください」と条件を加えた方が、実用的な回答が返ってきます。
効果的なプロンプトの基本は次のとおりです。
- 何を・どのように・どの範囲でを明確にし、あいまいさをなくす
- 役割を与える:「あなたは経理担当者です」のように立場を指定する
- 出力の形を指定する:文字数、箇条書き、表など
- 回答の例を見せる:望む回答の見本を1〜数個示す(フューショット)
- 段階を分ける:複雑な作業は小さな手順に分けて頼む
- 分からない時は分からないと答えさせる:推測で埋めさせない指示を入れる
- 指示と入力データを分ける:お客様の文章などを渡す時は、指示と区別して書く(プロンプトインジェクション対策)
RAG(検索拡張生成)
RAG(Retrieval-Augmented Generation)は、外部の資料から関係する情報を検索し、その情報をLLMに渡して回答を作らせる方法です。LLMそのものを学習し直さなくても、社内文書や最新の情報に基づいて答えさせることができます。
たとえば社内規程についての質問応答であれば、規程の文書から質問に関係する条文を探し、それを根拠としてLLMに説明文を作らせます。根拠になった資料を回答と一緒に示せるため、ハルシネーションを減らし、確認もしやすくなります。
一方で、検索する資料の質が回答の質を決めます。古い資料や重複した資料が混ざっていると、間違った根拠で答えてしまいます。資料の整理と更新が、RAGの成否を左右します。
ファインチューニング
ファインチューニングは、事前学習を終えたモデルに自社や業界のデータを追加で学習させ、特定の用途に合わせて調整する方法です。専門用語への対応、決まった文体や出力形式の安定、業界特有の言い回しの理解などに効果があります。
以前はモデルの全体を学習し直す必要があり、膨大な計算資源がかかりました。現在は、モデルのごく一部だけを追加学習させる方法が広く使われ、必要な計算資源を大きく減らせるようになっています。
- LoRA(Low-Rank Adaptation):元のモデルは固定したまま、小さな追加部分だけを学習させる方法
- PEFT(Parameter-Efficient Fine-Tuning):LoRAなどを含む、少ないパラメータだけを調整する方法の総称
- Adapter:元のモデルに小さな層を差し込み、その層だけを学習させる方法
オープン型のモデルであれば、Hugging Faceのライブラリなどを使ってこれらの方法を試せます。商用型のモデルでも、提供元がファインチューニングの機能をAPIで用意している場合があります。ただし、追加学習すると汎用的な能力が落ちることがあり、学習データの質と量(ノイズや重複の除去)が結果を大きく左右します。
弊社ではLLMを業務でこう使っています
ここからは、弊社が実際にLLMをどう使っているかをお伝えします。どれも日々の業務で動かしているもので、うまくいったことだけでなく、つまずいたことも含めて書きます。
AIチャットボットでのRAG
弊社が提供しているAIチャットボット「AIスミズミ」は、お客様のWebサイトの情報や資料を「ナレッジ」として登録し、質問が来るたびに関係する部分を探してLLMに渡すRAGの形で動いています。
チャットボットでは、回答の賢さと同じくらい返事の速さが大切です。待たされると利用者は離れてしまうため、弊社ではお客様向けの標準として、速くて利用料の安い軽めのモデルを使い、ログの分析のように時間をかけてよい作業には別のモデルを使い分けています。
ナレッジの登録では、次のことが分かっています。
- 1つのファイルに情報を詰め込みすぎると、検索の精度が落ちる。資料は内容ごとに分け、必要なものに絞って登録する方が、正しい部分を探し当てやすくなります
- 公開されているWebページは、URLの一覧を渡して読みに行かせる方が良い。資料を送ってもらって登録するより、手間が少なく、情報も新しく保てます
- ただし、ログインが必要なページは読めない。会員向けページなどの資料は、ファイルとして登録します
- ページ数の多いサイトでは、すべてを登録しない。商品写真などは登録せず、必要になった時にそのページを読みに行く仕組みにして、速さと精度を保っています
ハルシネーションでつまずいた実例
弊社のデモ用チャットボットで、表示してよい写真の一覧を空にしたまま、「写真を見せると喜ばれる場面では写真を出す」という指示だけを与えていたことがありました。その結果、LLMは存在しない画像のアドレスを作って表示しようとし、画像が壊れて表示されました。
「登録された一覧の中からしか選ばない。一覧に無ければ写真は出さない」という指示に改めたところ、解消しました。LLMは「無い」ことを自分から言うのが苦手で、指示の中に出すべきものがあると、無理にでも作ろうとします。選んでよい範囲を渡し、無い時の振る舞いをはっきり書くことが、業務で使う上での基本だと考えています。
記事づくりと事実確認
弊社のコンテンツSEOの支援では、LLMを組み込んだ社内ツールを使い、検索上位のページの本文を読み比べて記事の構成を作る作業、下書き、書いた後の事実確認を行っています。
事実確認の工程を必ず入れているのは、LLMが実在しない番号や数字をもっともらしく書くことがあるためです。公的機関や提供元の公式情報で確かめられない記述は、記事に載せないことにしています。
問い合わせの仕分け
弊社サイトへのお問い合わせは、営業メールなどの迷惑なものを、LLMによる判定と、あらかじめ決めた条件の両方で振り分けています。判定は間違うこともあるため、振り分けたものは一覧で人が確認できるようにしています。LLMに判断を任せきりにせず、人が後から確かめられる形にしておくことが大切です。
LLMを導入・利用する前に知っておくべき限界とリスクは?
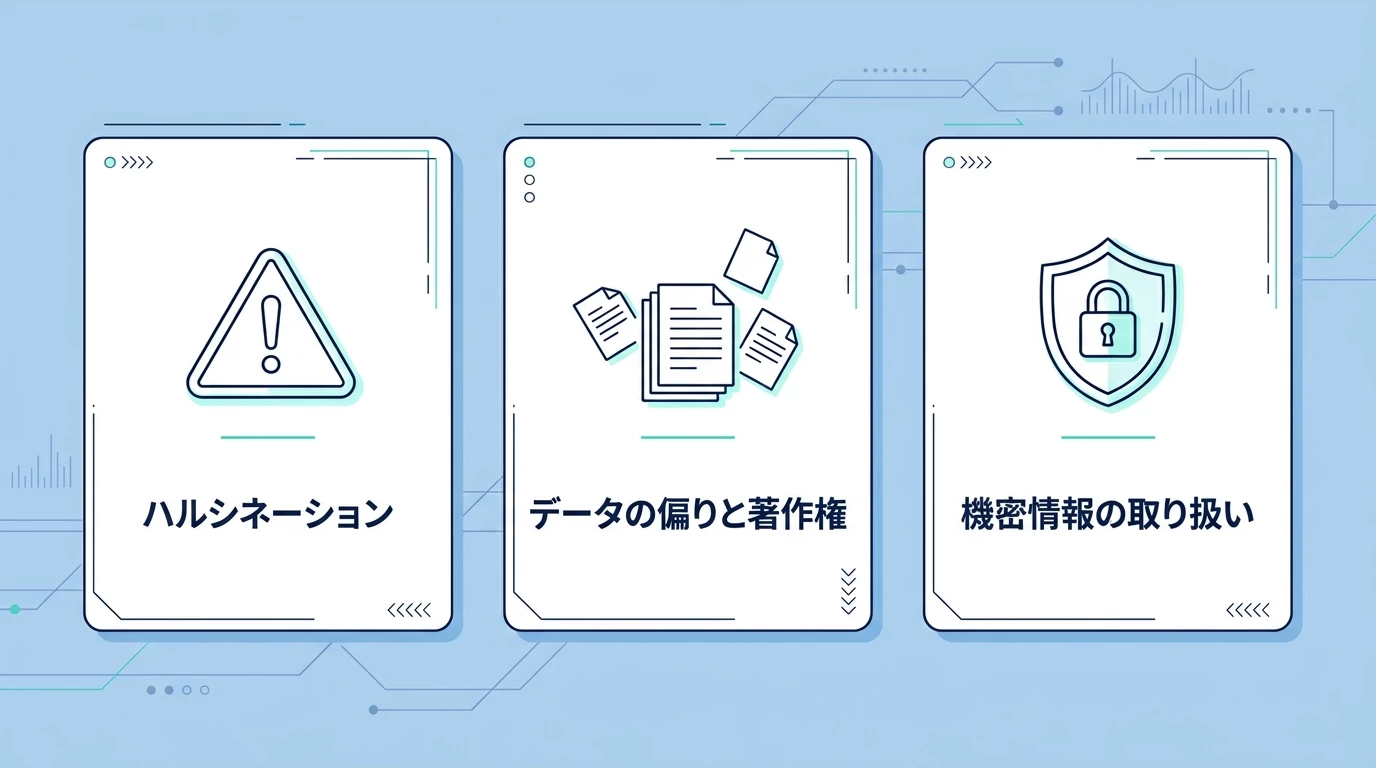
LLMには、事実と異なる内容をもっともらしく作ってしまう「ハルシネーション」という弱点があります。重要な判断をすべてLLMに任せるのは危険で、人によるチェックを前提に使うのが基本です。
技術的な限界
- ハルシネーション:存在しない情報や間違った数字を、自信を持って回答してしまう現象。専門性の高い質問や、学習データに少ない情報で起こりやすくなります
- 情報の古さ:学習した時点より後の出来事は知りません。最新の情報が必要な場合は、RAGや検索機能と組み合わせます
- 偏り:学習データの傾向によって、回答に偏りが出ることがあります
- 根拠の分かりにくさ:なぜその答えになったのかを、モデルの中から確かめることは難しく、根拠となる資料を示させる工夫が必要です
- 計算の費用:大きなモデルは多くの電力と計算資源を使います。用途に合った大きさのモデルを選ぶことが費用の抑制につながります
セキュリティと権利のリスク
- 機密情報の取り扱い:社員が個人の判断で顧客情報などを外部のAIサービスに入力してしまう(シャドーAI)と、情報漏えいにつながるおそれがあります。サービスによっては入力内容が学習に使われる設定もあるため、規約と設定を事前に確認してください
- プロンプトインジェクション:入力された文章の中に紛れ込ませた指示で、本来の制限をすり抜けさせる攻撃です。お客様が自由に入力できるチャットボットなどでは特に注意が必要です
- 著作権:生成した文章が既存の作品とよく似てしまう可能性があります。公開する文章は人が確認してください(関連記事:生成AIの著作権、どこまでセーフか)
安全に使うための対策
リスクを減らすために、現場では次のような対策が組み合わせて使われています。
- 人による確認:社外に出す文章や重要な判断は、必ず人が最終確認する
- 入力のルール:機密情報や個人情報を入力しない、入力してよいサービスを決める
- 出力の制限(ガードレール):答えてよい範囲や出してよい内容を事前に決め、外れた入出力を止める仕組みを入れる
- データの管理:RAGやファインチューニングに使う資料の出どころ・鮮度を確認し、個人情報は伏せる
- 利用の記録:誰がどのように使ったかを記録し、問題が起きた時に後から追えるようにする
AIの倫理という点では、公平性、透明性(判断の過程を説明できること)、説明責任、プライバシーの保護が重視されています。国内でも、総務省・経済産業省が「AI事業者ガイドライン」を公表しており、AIを使う事業者が気を付けるべき点が整理されています。
大切なのは、リスクを恐れて使わないことではなく、「どの業務になら安心して任せられるか」を見極めることです。最終確認を人が行う業務から始め、機密情報は入力しないルールを決めておけば、リスクを抑えながら十分に活用できます。
LLMは今後どうなっていくのか?
LLMは次のような方向に進んでいます。
- AIエージェント化:目的を伝えると、LLMが自分で手順を考え、検索や他のツールを使いながら複数の作業をこなす使い方が広がっています。「質問に答える」から「作業を任せる」への変化です
- マルチモーダル化:文章だけでなく、画像・図表・音声・動画をまとめて扱えるモデルが増えています
- 長い文書への対応:一度に読み込める文章の量が大きく増え、長い契約書や大量の資料をまとめて扱えるようになっています
- 小型で高性能なモデル:パソコンや社内のサーバーで動く小さなモデルの性能が上がり、データを外に出さずに使える選択肢が増えています
- 日本語に特化したモデル:国内企業や研究機関による日本語モデルの開発が続いています
一方で、AIに関する法律やルールづくりも国内外で進んでいます。技術と規制の両方の動きを追いながら、自社の使い方を見直していくことが大切です。
自社でLLMをどう活用すればいい?よくある悩みと進め方
「何から始めればいいか分からない」「ツールを入れても現場で使われない」という悩みは、中小企業でAI活用を検討する際によく聞かれます。こうした悩みには、いきなりツールを入れるのではなく、現場の業務に合わせて一緒に形にしていく進め方が有効です。
よくある3つの相談
弊社にいただくご相談で特に多いのが、次の3つです。
- 集計や転記の作業に毎月かなりの時間がかかっていて、効率化したい
- どの業務からAIを使い始めればよいか、社内で決めきれない
- 一度ツールを導入してみたものの、現場で使われないまま終わってしまった
これらに共通しているのは、「AIの性能」ではなく、「自社のどの業務に、どう組み込むか」の設計ができていないという点です。
弊社にも、「担当者によって答えがばらつく問い合わせ対応を、誰でも同じ水準で答えられるようにしたい」というご相談をいただくことがあります。話を伺っていくと、困っているのはLLMの性能ではなく、「社内のどの情報を、どう整理してAIに渡すか」という設計の部分であることがほとんどです。この設計を一緒に詰めていく作業が、導入の成否を分けると考えています。
FDE(フォワードデプロイドエンジニア)という進め方
弊社では、FDE(Forward Deployed Engineer=お客様の現場に入り、その場で使える形にAIを作り上げていく技術者)という考え方で支援しています。進め方は次の4ステップです。
▼現場に入って形にする4ステップ
現場に入る
実際の業務の流れを伺い、何にどれだけ時間がかかっているかを把握します。
その場で形にする
伺った内容をもとに、実際に使えるAIの仕組みを設計します。
現場で使ってもらう
作った仕組みを実際の業務で試していただき、使い勝手を確認します。
数字で確かめる
作業時間の変化など、実際の効果を数字で振り返り、改善します。
打ち合わせで伺った内容を整理していくと、それだけで仕様書に近い形になることがよくあります。実務の流れを一つずつ言葉にしていく中で、必要な機能が自然と見えてくるためです。社内に専門の人材がいなくても、この進め方であれば無理のない規模から始められます。
社内業務でのAI活用を具体的に検討する際は、AIコンサルティング(FDE型支援)のページもご覧ください。AIの開発会社を比べて選びたい方は、AI開発会社の種類・費用相場・選び方の記事も参考になります。
よくある質問(FAQ)
Q1. ChatGPTとLLMの違いは何ですか?
A1. LLMは文章を理解・生成する仕組み(モデル)の名前で、ChatGPTはOpenAIのLLM(GPTシリーズ)を使って作られた対話サービスの名前です。GeminiアプリやClaudeアプリも、それぞれGoogleやAnthropicのLLMを使ったサービスで、同じ関係にあります。
Q2. 生成AIとLLMの違いは何ですか?
A2. 生成AIは文章・画像・音声・動画などを作り出すAI全般を指す広い言葉で、LLMはその中で文章を扱う仕組みです。画像生成AIの多くは拡散モデルという別の仕組みで動いており、生成AIではあってもLLMではありません。
Q3. LLMとディープラーニングの違いは何ですか?
A3. ディープラーニングは、多層のニューラルネットワークでデータから学習する方法のことです。LLMはそのディープラーニングを使って、大量の文章から作られたモデルです。方法と、その方法で作られたもの、という関係です。
Q4. LLMとAIの違いは何ですか?
A4. AIは人の知的な作業をコンピューターで行う技術全体を指す最も広い言葉で、LLMはその中でも文章を扱う技術の一種です。画像認識や音声認識なども含む広いAIの中に、LLMが位置づけられています。
Q5. LLMの欠点は何ですか?
A5. 主な欠点は、もっともらしい誤りを作るハルシネーション、学習時点より後の情報を知らないこと、回答の根拠が分かりにくいこと、入力した情報の取り扱いに注意が要ることです。人による確認とRAGなどの仕組みを組み合わせて補います。
Q6. LLMとRAGの違いは何ですか?
A6. LLMは文章を作る仕組みそのもので、RAGはLLMに社内文書や最新の情報を検索して渡し、それに基づいて答えさせる使い方です。LLMが本体で、RAGはLLMの答えを自社の情報に合わせるための方法です。
Q7. ローカルLLMとは何ですか?クラウド型と何が違いますか?
A7. ローカルLLMとは、自社のサーバーやパソコンの中で動かすLLMのことです。社外にデータを送らないため情報漏えいの心配を抑えやすい一方、構築や運用には専門知識と機材が必要で、性能は最新の大規模な商用モデルに及ばないことが多いです。
Q8. LLMは無料で使えますか?
A8. ChatGPTなど一部のサービスには無料プランがありますが、業務で本格的に使う場合は有料プランやAPIの利用が前提になることが多いです。無料プランは入力内容の扱いが有料プランと異なる場合があるため、業務で使う前に規約を確認してください。料金は各社の公式サイトでご確認ください。
Q9. 中小企業でもLLMは導入できますか?専門知識がなくても大丈夫ですか?
A9. 専門の人材がいなくても、現場に入って一緒に設計する支援を受けながら、無理のない規模で始めることができます。まずは自社のどの業務から試すかを、打ち合わせの中で整理するところから始めると進めやすいです。
まとめ:LLMを理解した次の一歩
LLMとは、大量の文章データから言葉のつながりを学習し、次に来る言葉を予測しながら文章を作るAIの仕組みです。Transformerという仕組みと、データ・計算・パラメータの大規模化によって、人に近い自然な文章を扱えるようになりました。
GPT・Gemini・Claudeなどの商用型、Llamaなどのオープン型、国内の日本語特化型と選択肢は多く、自社のデータで精度を上げるには、プロンプトの工夫、RAG、ファインチューニングを目的に合わせて組み合わせます。
ハルシネーションや情報管理などの限界を理解した上で、大切なのは「自社のどの業務に使うか」を見極め、人が確認できる形で組み込むことです。設計さえ定まれば、専門の人材がいない会社でも着実に進められます。
LLMの理解を深めたら、次は自社業務への落とし込みです。現場に入って一緒に形にするご相談は、AIコンサルティング(FDE型支援)で承っています。何から始めればいいか分からない段階でも構いませんので、まずは無料相談・お問い合わせからご連絡ください。

コメント